Faster AI, on your own hardware.Une IA plus rapide, sur votre propre matériel.

We build Kyojin, an open-source engine that runs frontier open models on a single desktop PC or Mac, about 2× faster than llama.cpp on the same machine. And we put AI to work in real businesses.Nous développons Kyojin, un moteur open source qui fait tourner les meilleurs modèles ouverts sur un seul PC de bureau ou un Mac, environ 2× plus vite que llama.cpp sur la même machine. Et nous mettons l'IA au travail dans de vraies entreprises.
MIT licence · release 1.8.16 · AMD, NVIDIA and Apple SiliconLicence MIT · version 1.8.16 · AMD, NVIDIA et Apple Silicon
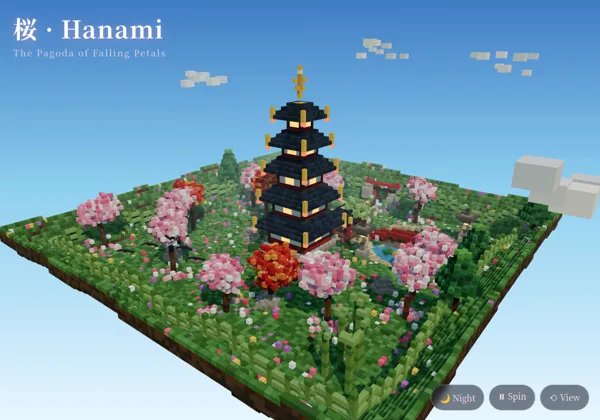
Voxel pagoda in a cherry-blossom garden, written by GLM-5.3-Flash running on Kyojin
Written in one prompt by GLM-5.3-Flash, running locally on Kyojin. Open itÉcrit en un seul prompt par GLM-5.3-Flash, en local sur Kyojin. L'ouvrir
237
GitHub stars, live countétoiles GitHub, compteur en direct
~1,000~1 000
developers installed Kyojin in 2 weeksdéveloppeurs ont installé Kyojin en 2 semaines
85,000+85 000+
downloads of our models on Hugging Facetéléchargements de nos modèles sur Hugging Face
~2×
faster than llama.cpp, the reference for local AIplus rapide que llama.cpp, la référence de l'IA locale
For developersPour les développeurs

Three commands to a local API.Trois commandes pour une API locale.

Install torch for your GPU and build once (doc/install.md), then:Installez torch pour votre GPU et compilez une fois (doc/install.md), puis :

$ git clone https://github.com/Yamz-Labs/kyojin && cd kyojin
$ hf download yamz-labs/Qwen3.8-Flash-Next-EXL3-Yamz --local-dir ./qwen-pack
$ python tools/qwen/serve.py --model ./qwen-pack --port 8000 -c 131072
# OpenAI API on http://localhost:8000/v1

Read morePour aller plus loin

Kyojin

Measured, not promised.Mesuré, pas promis.

One AMD mini PC with 128 GB. A real document read as a growing prompt, from 8,000 to 500,000 tokens: speed barely drops. Every figure links to its source.Un mini PC AMD avec 128 Go. Un vrai document lu comme un prompt qui grandit, de 8 000 à 500 000 tokens : la vitesse baisse à peine. Chaque chiffre renvoie à sa source.

Reading the promptLecture du prompt
tokens per second, by context lengthtokens par seconde, selon la longueur du contexte
0 600 1200 1800 8K 32K 64K 128K 256K 500K 1621 1224 652 567
Qwen3.8-Flash-NextGLM-5.3-Flash
Writing the answerÉcriture de la réponse
tokens per second, by context lengthtokens par seconde, selon la longueur du contexte
0 20 40 60 8K 32K 64K 128K 256K 500K 54.8 48.1 35.0 26.4
Qwen3.8-Flash-NextGLM-5.3-Flash

Kyojin 1.5.10, 17 Oct 2026, on a Ryzen AI Max+ 395: published packs, greedy, speculative decoding. Both models recalled two facts hidden at 40 % and 85 % of a ~500K-token prompt. Method and full tables: doc/benchmarks.md.Kyojin 1.5.10, 17/10/2026, sur un Ryzen AI Max+ 395 : packs publiés, greedy, décodage spéculatif. Les deux modèles retrouvent deux faits cachés à 40 % et 85 % d'un prompt d'environ 500K tokens. Méthode et tableaux : doc/benchmarks.md.

On NVIDIA too, ahead of llama.cpp.Aussi sur NVIDIA, devant llama.cpp.

Same sources, a CUDA path with hand-written kernels. On one RTX 3090 with Qwen3.8-27B, Kyojin keeps its speed as the context grows; llama.cpp slows down.Les mêmes sources, avec un chemin CUDA et des kernels écrits à la main. Sur une RTX 3090 avec Qwen3.8-27B, Kyojin garde sa vitesse quand le contexte grandit ; llama.cpp ralentit.

up to 3×jusqu'à 3×
faster than llama.cpp, depending on the modelplus rapide que llama.cpp, selon le modèle
Qwen3.8-27B on one RTX 3090Qwen3.8-27B sur une RTX 3090
writing speed, tokens per second, no speculationvitesse d'écriture, tokens par seconde, sans spéculation
0 10 20 30 40 50 4K 32K 128K ~250K 37.6 21.6
KyojinExLlamaV3llama.cpp

Same card, same prompts, greedy, one user. llama.cpp reads the prompt 8 to 19 % faster in this run. Weights differ (EXL3 against GGUF), so quality is not compared.Même carte, mêmes prompts, greedy, un utilisateur. llama.cpp lit le prompt 8 à 19 % plus vite dans cette mesure. Les poids diffèrent (EXL3 contre GGUF) : la qualité n'est pas comparée.

Checked against the originalVérifié face à l'original

Our packs pick the same next word as the official model 94 % of the time (Qwen) and 90 % (GLM).Nos packs choisissent le même mot suivant que le modèle officiel dans 94 % des cas (Qwen) et 90 % (GLM).

Several words per stepPlusieurs mots par étape

Speculative decoding drafts several tokens and checks them in one pass: up to 73 tokens per second on code.Le décodage spéculatif propose plusieurs tokens et les vérifie en une passe : jusqu'à 73 tokens par seconde sur du code.

Kernels written for the chipDes kernels écrits pour la puce

Custom GPU code for AMD (ROCm) and NVIDIA (CUDA). Speaks the OpenAI API, so your tools work as they are.Du code GPU sur mesure pour AMD (ROCm) et NVIDIA (CUDA). Compatible avec l'API OpenAI : vos outils marchent tels quels.

On a Mac too: 3,000 tokens/s to read.Sur un Mac aussi : 3 000 tokens/s en lecture.

Same engine, an MLX and Metal path in kyojin-mac. On one Mac Studio M3 Ultra, DeepSeek V4.1 Flash reads a 983,000-token prompt at 2,200 tokens/s and still writes at 48. Four sessions at 8K together write 112 tokens/s.Même moteur, une voie MLX et Metal dans kyojin-mac. Sur un seul Mac Studio M3 Ultra, DeepSeek V4.1 Flash lit un prompt de 983 000 tokens à 2 200 tokens/s et écrit encore à 48. Quatre sessions à 8K écrivent ensemble 112 tokens/s.

3,001
tokens/s reading an 8K prompttokens/s pour lire un prompt de 8K
112
tokens/s with 4 sessions at oncetokens/s avec 4 sessions à la fois
Writing the answer, on a MacÉcriture de la réponse, sur un Mac
tokens per second, by context lengthtokens par seconde, selon la longueur du contexte
0 20 40 60 80 8K 128K 983K 62 57 48.5
DeepSeek V4.1 Flash

Kyojin 1.8.9, Mac Studio M3 Ultra, 256 GB: real server, real text, one warm-up discarded then one measured run. Every figure links to its source.Kyojin 1.8.9, Mac Studio M3 Ultra, 256 Go : vrai serveur, vrai texte, un échauffement écarté puis une mesure. Chaque chiffre renvoie à sa source.

ModelsModèles

Ready-made packs, free to download.Des packs prêts à l'emploi, en libre accès.

Our own compressed builds. All but the experimental DeepSeek fit in 128 GB with room for long context.Nos propres versions compressées. Toutes, sauf DeepSeek (expérimental), tiennent dans 128 Go avec de la place pour un long contexte.

ModelModèleSizeTailleReading, tok/sLecture, tok/sWriting, tok/sÉcriture, tok/sSame word as originalMême mot que l'original
Qwen3.8-Flash-Next95 GB162147 – 7393.8 %HF →
GLM-5.3-Flash99.7 GB65227 – 3790.1 %HF →
MiMo-V2.6-Flash1.5105.8 GB76029 – 3792.0 %HF →
DeepSeek-V4.1-Flashexperimentalexpérimental185 GB187 – 2575 – 11–HF →

One Ryzen AI Max+ 395 with 128 GB, 8K-token prompt. Writing ranges cover prose, chat and code with speculative decoding (DeepSeek: plain decoding on real sessions). DeepSeek is larger than memory: Kyojin reads part of the model from the SSD, exactly, so it is a demonstration rather than a daily assistant (how it works).Un Ryzen AI Max+ 395 avec 128 Go, prompt de 8K tokens. Les plages d'écriture couvrent prose, chat et code avec décodage spéculatif (DeepSeek : décodage simple sur de vraies sessions). DeepSeek est plus gros que la mémoire : Kyojin lit une partie du modèle depuis le SSD, à l'identique. C'est une démonstration plutôt qu'un assistant du quotidien (comment ça marche).

WorkRéalisations

AI that works in production.De l'IA qui travaille, en production.

GETA Solutions

GETA Solutions

E-commerce platform · designed, built and run by usPlateforme e-commerce · conçue, codée et exploitée par nous

An online store for truck tyres and services. Its AI agent does real work: it searches the catalogue, tracks orders, fills the cart and books a callback. Few online stores have one.Un site marchand de pneus poids lourd et de services. Son agent IA fait un vrai travail : il cherche dans le catalogue, suit les commandes, remplit le panier et programme un rappel. Peu de sites marchands en ont un.

  • 13 tools for the agent, several models with automatic fallback.13 outils pour l'agent, plusieurs modèles avec relais automatique.
  • 28 background jobs: invoices, payment and quote reminders, bank reconciliation, competitor pricing, supplier stock, Google Ads.28 tâches automatiques : factures, relances de paiement et de devis, rapprochement bancaire, prix des concurrents, stocks fournisseurs, Google Ads.
  • 100,000 lines, 3,200+ tests, 640+ pull requests gated by continuous integration.100 000 lignes, 3 200+ tests, 640+ pull requests validées par intégration continue.
  • Nearly €40k revenue in 3 months.Près de 40 k€ de chiffre d'affaires en 3 mois.
DjangoPostgreSQLStripeLLM agentsagents LLMGitHub Actions

Recorded on the live site. Waiting time sped up.Filmé sur le site en ligne. Attente accélérée.

Merged into llama.cppIntégré à llama.cpp

Our code is in llama.cpp, the reference library for local AI: support for NVIDIA's Nemotron-3 models, reviewed and merged by the maintainers.Notre code est dans llama.cpp, la bibliothèque de référence de l'IA locale : le support des modèles Nemotron-3 de NVIDIA, relu et fusionné par les mainteneurs.

85,000+ downloads85 000+ téléchargements

New models from Tencent, Xiaomi and NVIDIA, converted so they run locally, often days after release. Published on Hugging Face.De nouveaux modèles de Tencent, Xiaomi et NVIDIA, convertis pour tourner en local. Publiés sur Hugging Face.

For companiesPour les entreprises

What we can do for you.Ce que nous pouvons faire pour vous.

Your GPUs, fully usedRentabiliser vos GPU

Setup, tuning and before/after numbers, from one card to a rack: RTX, DGX Spark, AMD.Installation, réglage et mesures avant/après, d'une carte à une baie : RTX, DGX Spark, AMD.

A private AIUne IA privée

In-house models instead of subscriptions. Your data stays inside your company.Des modèles internes au lieu d'abonnements. Vos données restent dans l'entreprise.

Automate the workAutomatiser le métier

Agents and background jobs, as at GETA: quotes, reminders, invoices, customer support.Agents et tâches automatiques, comme chez GETA : devis, relances, factures, support client.

AboutÀ propos

A small lab near Paris.Un petit labo près de Paris.

Yamz Labs is run by Yaniss Amazouz, AI engineer from Télécom SudParis (IP Paris), based in Essonne. Kyojin, our models and the GETA platform are built here, with a 24/7 lab of AI agents that code, test and measure.Yamz Labs est dirigé par Yaniss Amazouz, ingénieur IA diplômé de Télécom SudParis (IP Paris), basé dans l'Essonne. Kyojin, nos modèles et la plateforme GETA sont construits ici, avec un labo d'agents IA qui codent, testent et mesurent 24 h/24.

Let's talk.Parlons-en.

A project, a GPU park to put to work, or a question about Kyojin. Un projet, un parc de GPU à mettre au travail ou une question sur Kyojin.